Análise Exploratória de Dados: como transformar uma base de dados em informação antes de construir qualquer modelo
Quando pensamos em Ciência de Dados, Inteligência Artificial e Machine Learning, é comum imaginar algoritmos sofisticados, modelos preditivos, redes neurais e grandes volumes de dados sendo processados por computadores poderosos. No entanto, antes de qualquer modelo ser treinado, existe uma etapa muito mais fundamental: entender os dados que temos em mãos.
É justamente esse o papel da Análise Exploratória de Dados, conhecida pela sigla EDA, do inglês Exploratory Data Analysis.
A EDA não começa perguntando qual algoritmo devemos utilizar. Ela começa com perguntas muito mais básicas — e extremamente importantes:
Que dados temos? Como eles estão organizados? Qual é o comportamento típico desses dados? Quanto eles variam? Existem valores muito diferentes dos demais? Algumas variáveis parecem estar relacionadas? Existem padrões que merecem investigação?
Essas perguntas formam uma das bases do trabalho de um cientista de dados.
Neste artigo, vamos percorrer os principais conceitos da Análise Exploratória de Dados, passando por tipos de dados, dados retangulares, medidas de localização, variabilidade, percentis, outliers, correlação e visualização.
O que é Análise Exploratória de Dados?
Imagine que uma empresa possua milhares de registros de clientes contendo informações como idade, renda, número de compras, valor gasto, cidade, categoria do cliente e nível de satisfação.
Antes de tentar prever quais clientes comprarão novamente, quais poderão cancelar um serviço ou quanto cada cliente deverá gastar no próximo mês, precisamos primeiro conhecer essa base.
É aí que entra a EDA.
Podemos pensar no processo da seguinte maneira:
Dados brutos
↓
Organização
↓
Análise Exploratória
↓
Compreensão dos dados
↓
Identificação de padrões e problemas
↓
Análises estatísticas / modelos
↓
Decisões
A análise exploratória procura resumir e visualizar as principais características dos dados.
Ela também pode revelar problemas importantes.
Podemos descobrir, por exemplo, que determinada coluna possui muitos valores ausentes; que existem registros duplicados; que uma variável possui valores absurdamente altos; que determinada categoria domina quase toda a base; ou que duas variáveis apresentam uma relação muito forte.
Portanto, a EDA não é simplesmente uma coleção de gráficos bonitos.
Ela representa uma investigação.
O cientista de dados está fazendo perguntas aos dados e utilizando estatística e visualização para encontrar respostas.
1. Antes de analisar, precisamos conhecer os tipos de dados
Uma das primeiras tarefas consiste em identificar que tipo de dado cada variável representa.
Uma divisão fundamental é entre dados numéricos e categóricos.
Os dados numéricos representam quantidades sobre as quais operações matemáticas normalmente fazem sentido. Eles podem ser contínuos ou discretos.
Uma variável contínua pode assumir valores dentro de um intervalo. Altura, peso, temperatura, velocidade e tempo são exemplos clássicos.
Uma pessoa pode ter 1,70 metro, outra 1,704 metro e assim por diante.
Já uma variável discreta normalmente representa contagens.
Número de filhos, quantidade de clientes, número de acidentes e quantidade de produtos vendidos são exemplos.
Não esperamos encontrar uma família com 2,37 filhos em uma observação individual. A contagem assume valores inteiros.
Os dados categóricos, por outro lado, representam grupos ou classes.
Estado de residência, profissão, tipo de produto e modalidade de pagamento são exemplos.
Dentro dos dados categóricos encontramos ainda distinções importantes.
Uma variável nominal apresenta categorias sem uma ordem natural. Por exemplo:
Vermelho
Azul
Verde
Amarelo
Não existe motivo estatístico para afirmar que azul é “maior” do que verde.
Já uma variável ordinal possui uma ordem natural.
Considere:
Ruim
Regular
Bom
Muito bom
Excelente
Existe uma progressão entre as categorias.
Também encontramos variáveis binárias, que possuem apenas duas possibilidades, como:
Sim / Não
0 / 1
Aprovado / Reprovado
Essa classificação parece simples, mas possui consequências importantes.
Se um computador receber:
Azul = 1
Verde = 2
Vermelho = 3
esses números não significam necessariamente que vermelho seja três vezes alguma característica de azul. Os números podem ser apenas códigos.
Por isso, entender o significado da variável é tão importante quanto conhecer a forma como ela está armazenada.
2. Dados retangulares: a estrutura que encontramos nas planilhas
Grande parte dos dados utilizados em análises empresariais aparece em uma estrutura bastante familiar: uma tabela.
É o que podemos chamar de dados retangulares.
Imagine
| Cliente | Idade | Renda | Compras | Satisfação |
|---|---|---|---|---|
| Ana | 32 | 4.500 | 5 | 4 |
| Carlos | 41 | 7.200 | 8 | 5 |
| Joana | 28 | 3.900 | 3 | 3 |
Cada linha representa uma observação ou registro.
Cada coluna representa uma variável.
Em Ciência de Dados, também encontraremos palavras como feature, atributo e preditor para nos referirmos a determinadas variáveis, dependendo do contexto.
Essa estrutura aparece em arquivos CSV, planilhas do Excel, bancos de dados e data frames utilizados por Python e R.
Entretanto, nem todos os dados possuem uma estrutura puramente tabular.
Séries temporais, redes, dados geográficos, textos, imagens e outros tipos de informação podem exigir estruturas e técnicas específicas.
Mesmo quando alguns deles podem ser armazenados em tabelas, suas relações internas não são completamente representadas pela simples ideia de linhas independentes.
3. Estimativas de localização: onde está o centro dos dados?
Suponha que tenhamos os salários de centenas de trabalhadores.
Olhar individualmente para centenas de números não seria muito útil. Precisamos de medidas capazes de resumir o conjunto.
Uma das primeiras perguntas é:
Qual valor representa aproximadamente o centro desses dados?
Entramos então nas estimativas de localização, também relacionadas ao conceito de tendência central.
A mais conhecida é a média aritmética.
Se tivermos:
10, 12, 14, 16, 18
a média será:
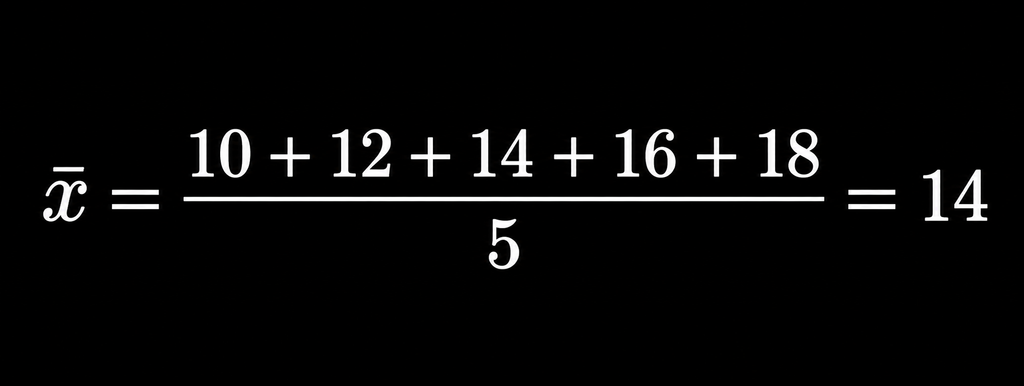
A média utiliza todos os valores do conjunto.
Isso é uma qualidade importante, mas também cria uma característica que precisamos conhecer: a média é sensível aos valores extremos.
Considere agora:
10, 12, 14, 16, 100
O valor 100 exerce uma influência considerável sobre a média.
É aqui que outra medida se torna importante: a mediana.
4. Mediana: o valor central
Para encontrar a mediana, primeiro ordenamos os valores.
Considere:5, 8, 10, 12, 90
O valor central é:
10
Essa é a mediana.
Observe algo interessante.
Se transformarmos 90 em 9.000.000:
5, 8, 10, 12, 9.000.000
a mediana continua sendo:
10
Isso acontece porque a mediana depende principalmente da posição dos valores ordenados, e não da magnitude do valor extremo.
É por isso que ela é considerada uma medida mais robusta em relação aos outliers.
Essa diferença é extremamente importante.
A média pergunta, de certa forma, pelo equilíbrio aritmético dos valores.
A mediana procura o ponto que divide os dados ordenados ao meio.
Nenhuma das duas é universalmente “melhor”. A escolha depende das características da distribuição e do objetivo da análise.
5. Média aparada: um caminho intermediário
Existe ainda uma alternativa interessante chamada média aparada.
A ideia é retirar uma pequena porcentagem dos menores e dos maiores valores antes de calcular a média.
Imagine uma distribuição com algumas observações extremamente altas.
Em vez de permitir que esses poucos valores tenham grande influência sobre o resultado, podemos retirar, por exemplo, determinada proporção de cada extremidade e calcular a média dos valores restantes.
A média aparada procura combinar algumas características da média com maior resistência aos valores extremos.
Ela nos apresenta uma lição importante da Estatística:
a escolha da medida depende da natureza dos dados.
6. Outliers: quando uma observação se distancia das demais
Um outlier é uma observação muito distante do comportamento apresentado pela maioria dos dados.
Considere:
10
11
11
12
13
14
95
O valor 95 chama imediatamente a atenção.
Ele pode ser um outlier.
Mas existe um cuidado fundamental:
Outlier não significa necessariamente erro.
Imagine uma base de salários.
A maioria das pessoas pode ganhar entre R$ 3 mil e R$ 10 mil, enquanto um executivo recebe R$ 80 mil.
O salário do executivo pode aparecer como uma observação extrema, mas continua sendo um dado verdadeiro.
Por outro lado, se encontrarmos uma idade de 350 anos em um cadastro de clientes, provavelmente temos um problema de qualidade dos dados.
Portanto, identificar um outlier é apenas o início.
Depois precisamos perguntar:
Por que esse valor existe?
Pode ser erro de digitação, falha de medição, fraude, evento raro ou simplesmente uma observação legítima.
Essa investigação é parte da EDA.
7. Localização não é suficiente: precisamos medir a variabilidade
Imagine duas turmas:
Turma A:
7, 7, 7, 7, 7
Turma B:
3, 5, 7, 9, 11
As duas possuem média igual a 7.
Mas claramente não apresentam o mesmo comportamento.
Na primeira, todos obtiveram exatamente a mesma nota.
Na segunda, os resultados estão bastante espalhados.
A média sozinha não consegue mostrar essa diferença.
Precisamos então medir a variabilidade, também chamada de dispersão.
A pergunta deixa de ser:
Onde está o centro?
e passa a ser:
Quanto os valores estão espalhados ao redor desse centro?
Essa é uma das ideias mais importantes da Estatística.
8. Desvios: a distância em relação ao centro
Imagine uma média igual a 10.
Se uma observação vale 13, seu desvio em relação à média é:\[ 13-10=3 \]
Se outra observação vale 8:\[ 8-10=-2 \]
Portanto, um desvio mostra quanto uma determinada observação está afastada do centro considerado.
O problema é que desvios positivos e negativos podem se cancelar quando simplesmente somados.
É daí que surgem diferentes estratégias para resumir essas distâncias.
Uma delas é elevar os desvios ao quadrado.
Chegamos à variância.
9. Variância: medindo a dispersão por meio dos desvios quadráticos
A variância considera as distâncias dos valores em relação à média, elevando essas distâncias ao quadrado.
Para uma amostra, uma forma comum da fórmula é: